 姐夫
系统后台使用文档
你可以通过本文档了解后台的日常操作方法,包括登录后台、管理站点、绑定域名、维护数据、编辑模板、查看日志、备份迁移、AI 生成和内容采集等功能。
截图用于辅助定位,页面布局以当前安装版本为准。标签示例使用本页说明的数据分组;未建立的分组需要先创建。
1. 系统简介
本系统是一套站点内容管理与页面生成后台,可用于管理站点、域名、访问控制、数据、模板、AI 生成、网页采集、访问日志和站点备份迁移。
系统主要由以下部分组成:
- 前台引擎:根据域名、站点配置、模板和数据生成页面。
- 网页后台:提供可视化管理界面。
- 模板标签:支持文本、JSON、文件、随机字符、循环、截取、编码等内容调用和处理。
- 访问控制:按黑名单、搜索引擎、普通访客进行分流。
- 任务系统:支持 AI 内容生成和网页采集任务。
- 日志系统:记录并统计站点访问。
2. 登录后台
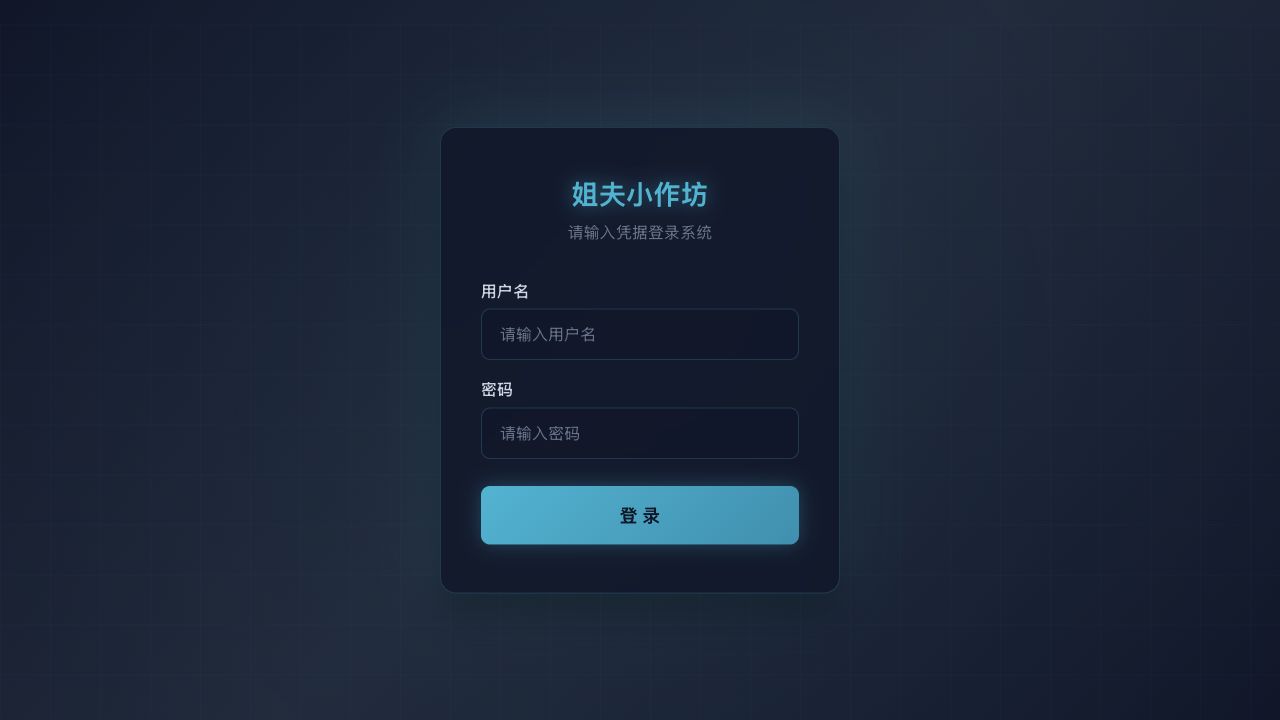
在浏览器中打开你的后台登录地址,输入账号和密码后点击「登录」。
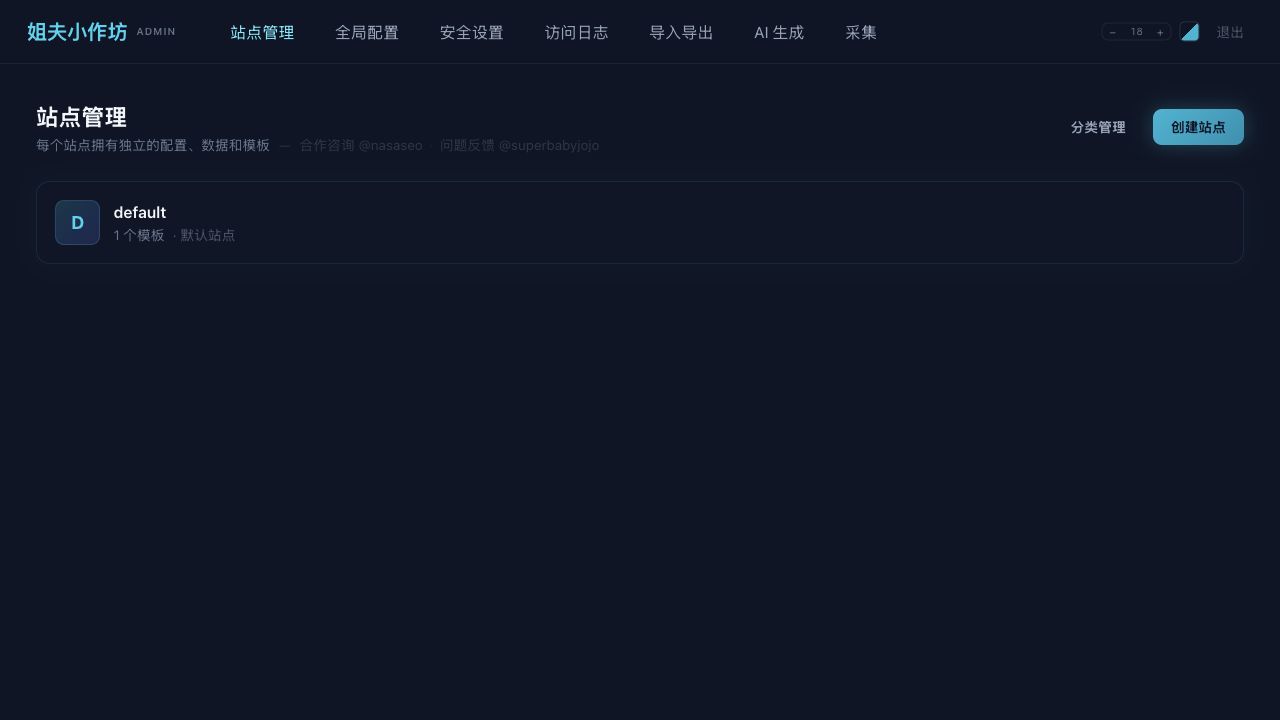
登录后进入「站点管理」。从侧栏进入全局配置、系统设置、访问日志、导入导出、AI 生成和采集;侧栏可收起。
建议首次登录后进入「系统设置」修改初始密码,并妥善保存新的登录信息。
3. 站点管理
「站点管理」用于创建、复制、分类和进入各个站点。
常用操作:
- 创建站点:点击「创建站点」,填写站点 ID、备注、分类后创建。
- 进入站点:在站点列表中点击站点名称或对应操作。
- 分类管理:维护站点分类,便于站点数量较多时筛选。
- 备注/分类:给站点补充说明信息。
- 复制:复制已有站点作为新站点基础。
- 改名/删除:非默认站点支持改名和删除。
注意事项:
- 站点 ID 仅建议使用字母、数字、下划线、连字符。
- 不能删除当前设置的默认站点。默认站点由「系统设置」指定,不以站点名称是否为 default 判断。
- 复制站点会复制该站点配置、数据、模板等内容。
4. 站点详情
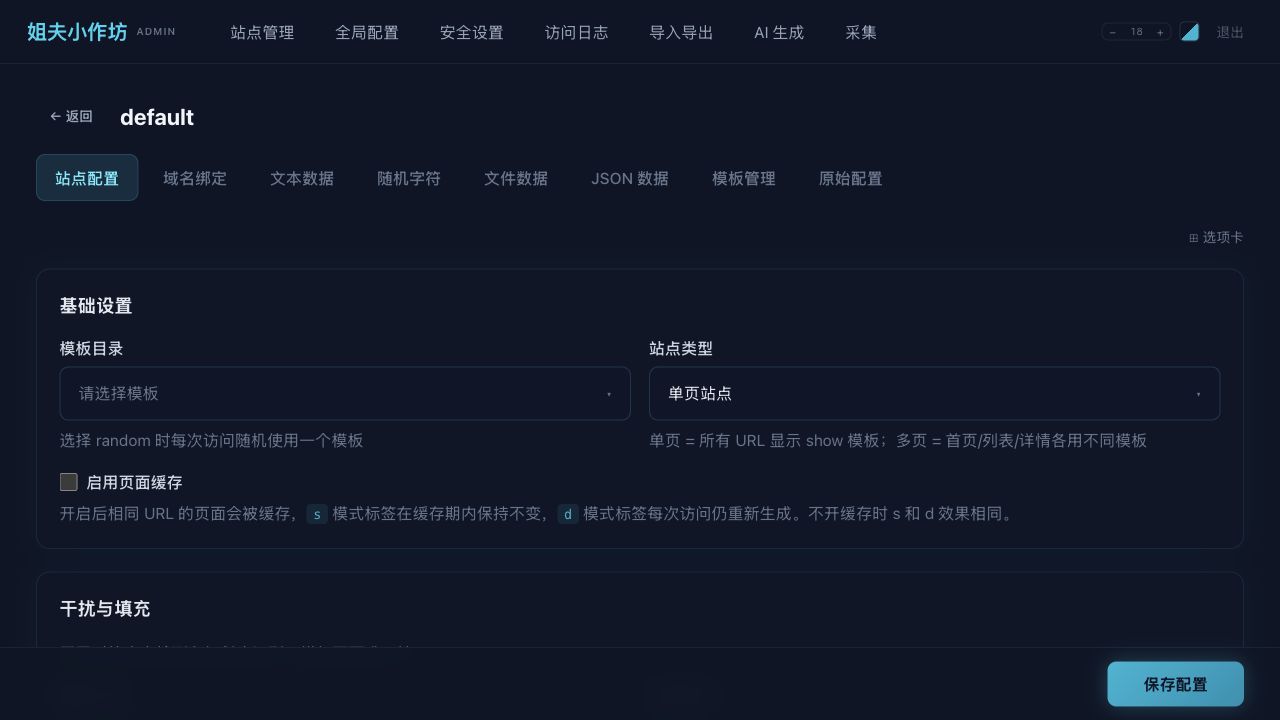
进入站点后,可看到多个管理页签:站点配置、域名绑定、文本数据、随机字符、文件数据、JSON 数据、模板管理、原始配置。
4.1 站点配置
首次部署要选择模板组:进入默认站点的「站点配置」,把模板目录选择为 default 并保存。交付包文件位于 sites/default/templates/default/,初始配置的模板名为空;留空并不会自动选择这个子目录。
站点配置用于控制当前站点的渲染方式、缓存、干扰、访问控制和替换规则。
主要区域:
- 基础设置:选择模板目录、站点类型、是否启用页面缓存。
- 干扰与填充:设置 HTML 属性干扰、页面体积填充。
- 访问控制:选择使用全局访问控制,或为当前站点启用自定义规则。
- 内容替换:配置模板占位文本的替换值。
- 高优先级替换:在普通替换前执行,适合包含循环或嵌套标签的大段 HTML。
站点类型:
- 单页站点:所有 URL 使用
show.html模板。 - 多页站点:首页使用
index.html,列表页使用list.html,详情页使用show.html。
页面缓存:
- 开启后,相同 URL 的页面会缓存。
{s:...}静态标签在缓存期内保持不变。{d:...}动态标签每次访问仍会重新生成。
多页站点怎样选模板
| 访问路径 | 模板 |
|---|---|
/ | index.html |
/news/ | list.html |
/news/a.html 或 /news/?page=2 | show.html |
单页模式统一使用 show.html。开启页面缓存时,模板修改后清除对应缓存再验证;关闭缓存时,静态和动态数据标签都会重新处理。
HTML / PDF 输出
在「页面输出」选择 HTML 或 PDF。PDF 模式先渲染 HTML,再交给服务器的 wkhtmltopdf 转换;只上传 SO 和 PHP 文件不足以启用 PDF。
使用 PDF 前,服务器需要准备三样东西:
wkhtmltopdf:把网页转换成 PDF。timeout:转换超时后结束进程,避免任务一直卡住。它是服务器上的命令工具,不是后台要填写的参数。- 中文字体:避免生成的 PDF 缺字。
在「PDF 输出」填写 wkhtmltopdf 的完整路径,不附加命令参数。确认 PHP-FPM 可以启动转换进程、程序目录下的 runtime/ 可写,再用一页中文模板测试。没有配置转换环境时,保持 HTML 即可。
PDF 环境检查
timeout 使用 GNU 版本,需位于 /usr/bin/timeout 或 /bin/timeout。同时检查 UTF-8 字符环境、纸张大小及显示方式。
PDF 文件不进入页面缓存;HTML 标签仍遵循当前页面缓存设置。转换失败时检查服务器错误日志和转换环境。
4.2 域名绑定
「域名绑定」用于把域名或泛域名绑定到当前站点。
示例:
example.com
www.example.com
*.example.com
访问某个域名时,系统会根据绑定关系选择对应站点。未命中绑定关系时,会使用「系统设置」里的默认站点。
4.3 文本数据
文本数据用于维护按行随机读取的数据源。模板中可通过标签调用。
示例标签:
{s:text:keyword}
{d:text:keyword}
常见用途:
- 随机标题
- 随机段落
- 随机关键词
- 随机链接文本
交付包已有 keyword 分组,内容为「关键词一」「关键词二」「关键词三」。例如 {s:text:keyword} 会抽取其中一行;不是按第一行固定输出。
4.4 随机字符
随机字符用于维护字符集,模板中可按长度生成随机字符串。
示例标签:
{s:rand:alpha:8}
{d:rand:alpha:6:12}
适合用于生成随机 class、ID、参数、短码等。
4.5 文件数据
文件数据用于上传和管理 .txt 文件分组。模板可读取文件名或文件内容。
示例标签:
{s:file:example:name}
{s:file:example:content}
常见用途:
- 批量文章片段
- HTML 片段
- 大段落内容
4.6 JSON 数据
JSON 数据用于维护结构化数据。AI 生成和采集结果通常会保存到 JSON 数据分组。
示例标签:
{s:json:example:title}
{s:json:example:content}
{d:json:example:title}
模板可以直接读取字段,也可以通过 random 随机读取一条数据,例如:
{s:json:example:title:random}
{s:json:example:content:1}
{d:json:example:author.name:random}完整语法、字段路径、随机读取和组合用法请查看核心模板标签手册。
数字后缀是抽取结果的复用标记,不是文件序号。标题和正文使用同一分组、同一标记,例如 {s:json:example:title:1} 与 {s:json:example:content:1}。分别使用 :random 可能取到不同记录。实际输入与输出见 JSON 示例。
4.7 模板管理
模板管理用于维护前台页面模板和模板资源。
核心模板文件:
index.html:首页模板。list.html:列表页模板。show.html:详情页模板。
模板资源可用于上传 CSS、JS、图片等素材。后台支持新建、编辑、改名、删除模板文件和资源文件。
4.8 原始配置
原始配置用于直接编辑当前站点的 JSON 配置。仅建议技术人员使用。
日常使用时优先使用「站点配置」可视化表单,避免 JSON 格式错误导致站点异常。
点击「保存域名」后,以绿色的「当前内容已保存」为准;有草稿、正在保存、失败会分别提示。跨站重复绑定会被拒绝,请先核对原归属。
5. 全局配置
「全局配置」用于设置所有站点默认共用的访问控制规则。单个站点可以选择继承全局配置,也可以切换为自定义设置。
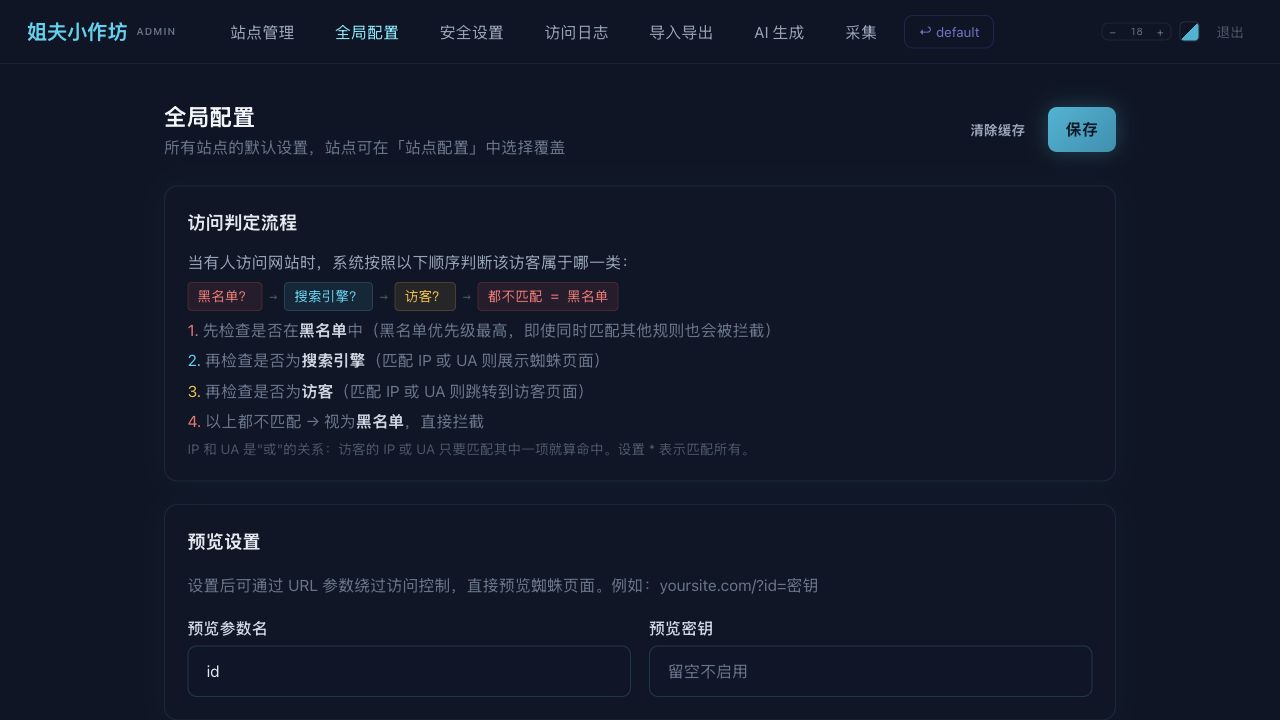
访问判定流程:
- 先检查黑名单。
- 再检查搜索引擎。
- 再检查访客。
- 都不匹配时,视为黑名单。
规则说明:
- IP 和 UA 是「或」关系,任意一个命中即算命中。
- 黑名单优先级最高。
- 支持
*通配符。 - IP 支持通配符和 CIDR。
- UA 关键词不区分大小写,包含即匹配。
主要配置项:
- 预览参数名:例如
id。 - 预览密钥:设置后可通过
?id=密钥预览蜘蛛页面。 - 启用代理头检测:使用 CDN 或反向代理时才开启。
- 搜索引擎 IP/UA:命中后展示模板渲染页面。
- 访客 IP/UA:命中后展示访客页面。
- 黑名单 IP/UA:命中后展示拦截页面。
- 默认页面内容:设置访客页面和黑名单拦截页面。
重要提醒:
如果开启代理头检测,必须正确配置 Nginx 的可信代理 IP,否则可能被伪造 X-Forwarded-For 绕过规则。
6. 系统设置
「系统设置」用于管理后台访问路径、默认站点和管理员密码。
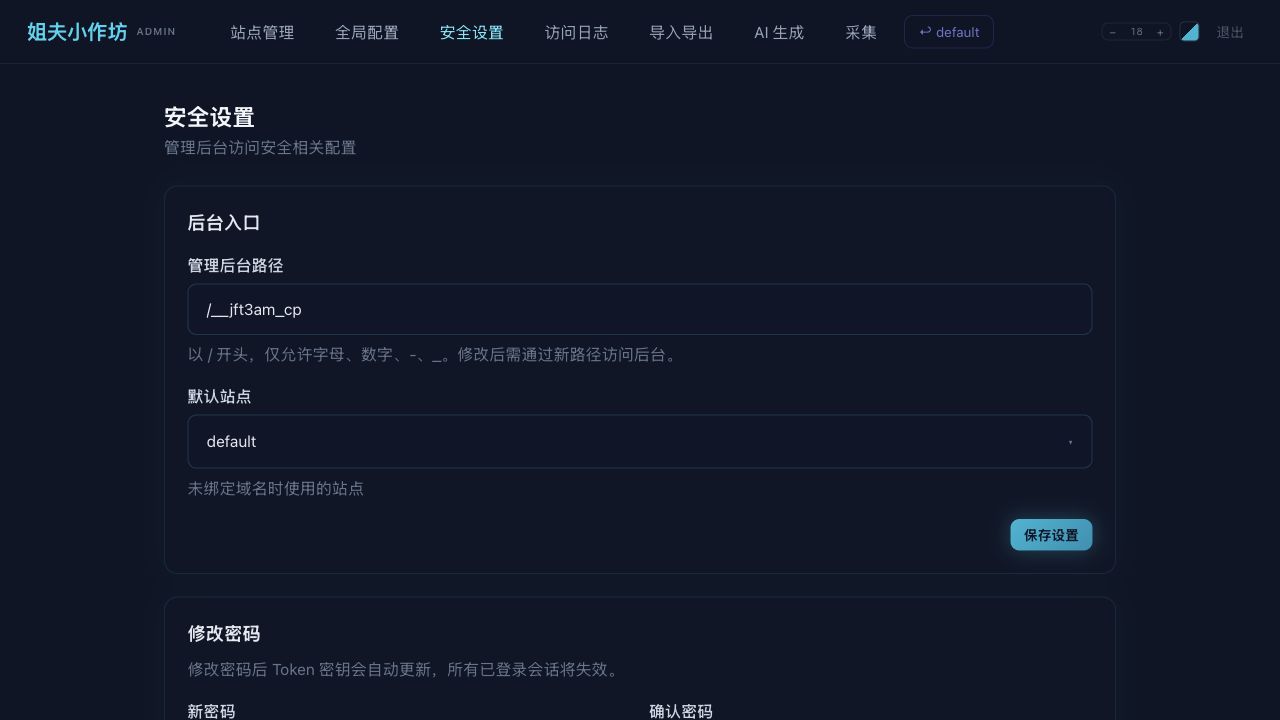
主要操作:
- 修改后台路径:后台路径必须以
/开头,仅允许字母、数字、-、_。 - 设置默认站点:未绑定域名时使用该站点。
- 修改密码:修改后所有已登录会话会失效,需要重新登录。
系统保留路径:
/api/tpl
这些路径属于系统内部使用路径,不应设置为后台入口。
建议:
- 首次使用后立即修改默认密码。
- 后台路径不要使用过于常见的名称。
- 修改后台路径后,请记录新地址,避免无法登录。
7. 访问日志
「访问日志」用于查看站点访问记录、24 小时趋势、域名统计、根域名统计和 IP 标记。
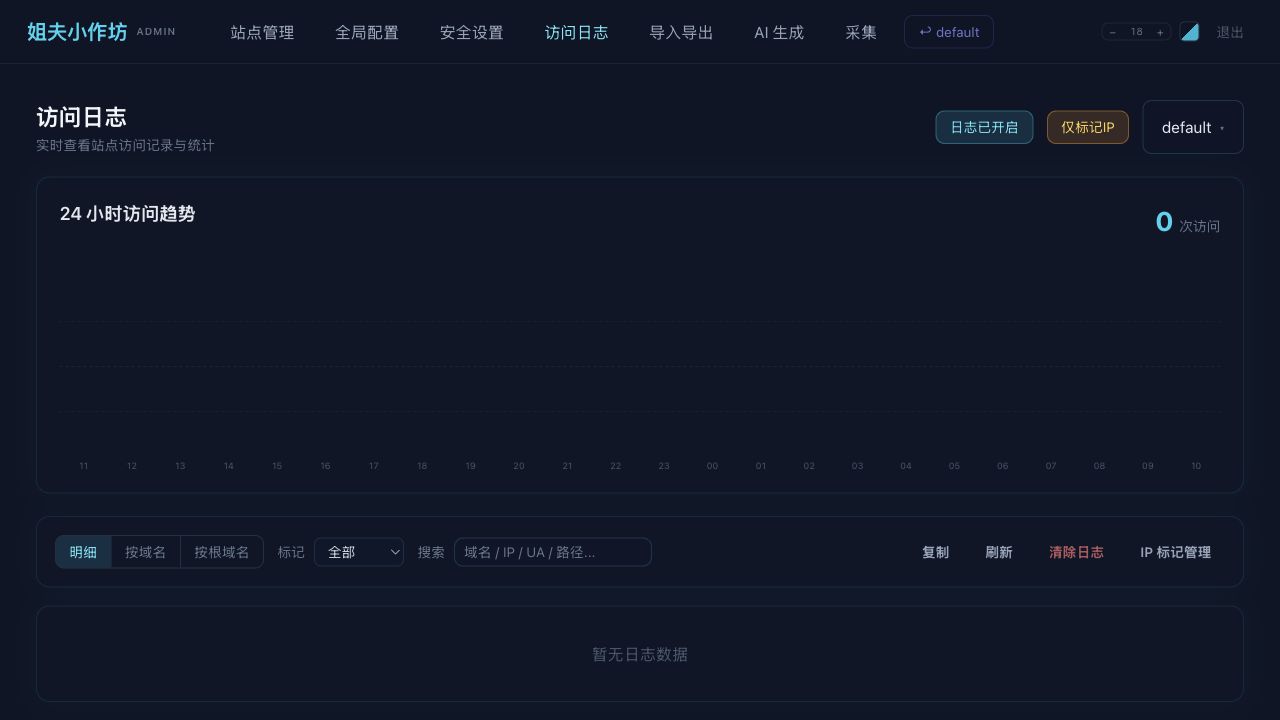
主要功能:
- 日志开关:启用或关闭访问日志。
- 仅标记 IP:只记录已打标 IP,减少日志量。
- 站点筛选:查看指定站点日志。
- 24 小时趋势:查看每小时访问变化。
- 明细:查看单条访问记录。
- 按域名:按访问域名聚合统计。
- 按根域名:按根域名聚合统计。
- 搜索:按域名、IP、UA、路径筛选。
- 复制:复制当前页数据。
- 清除日志:删除当前站点日志。
- IP 标记管理:给特定 IP 设置标签和颜色。
常见用途:
- 判断搜索引擎是否访问站点。
- 检查某个域名是否有流量。
- 识别异常 UA 或异常 IP。
- 对重要搜索引擎 IP 打标。
蜘蛛状态
在「访问日志」切换到「蜘蛛状态」,查看当前站点绑定根域名的最近访问、IP 标记和正常 / 异常状态;同根子域名合并展示。
当前版本只统计 UTC+8 当天日志。默认正常时限为 10 分钟,可在工具栏修改并保存;超过时限或当天没有符合条件的记录会显示异常。可按搜索条件和 IP 标记筛选,再分别复制正常、异常域名。
这里依据已有 IP 标记判断,不是独立的蜘蛛身份验证。页面每 15 秒更新;日志未开启、仍在准备数据或读取失败时,先解决提示问题再判断状态。
8. 导入导出
「导入导出」用于导出站点配置包或从配置包恢复站点。
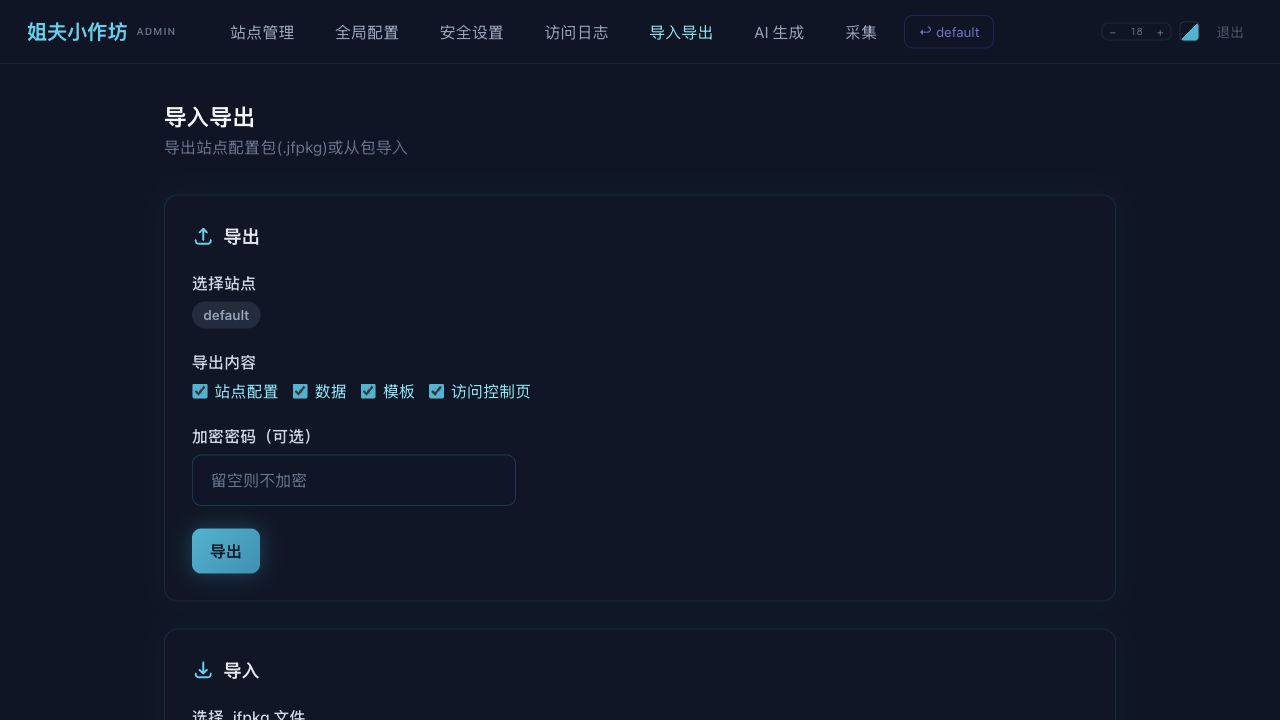
导出内容可选择:
- 站点配置
- 数据
- 模板
- 访问控制页
导出包格式为 .jfpkg。可以设置加密密码;留空则不加密。
导入时需要选择 .jfpkg 文件。如果导出包设置过密码,需要填写解密密码。
冲突处理方式:
- 覆盖已有站点
- 合并
- 跳过已有站点
- 改名导入冲突站点
建议:
- 大改配置前先导出备份。
- 迁移服务器时优先使用导出/导入。
- 加密包请妥善保存密码,忘记后无法正常导入。
大包会经过上传、预检、解压和提交等阶段。等待当前阶段结束,不把上传结束当作导入完成;页面显示失败或冲突时,先处理提示再重试。更改站点、目录或冲突策略前,确认操作目标。
9. AI 生成
「AI 生成」用于批量调用模型生成内容,并保存到站点数据中。
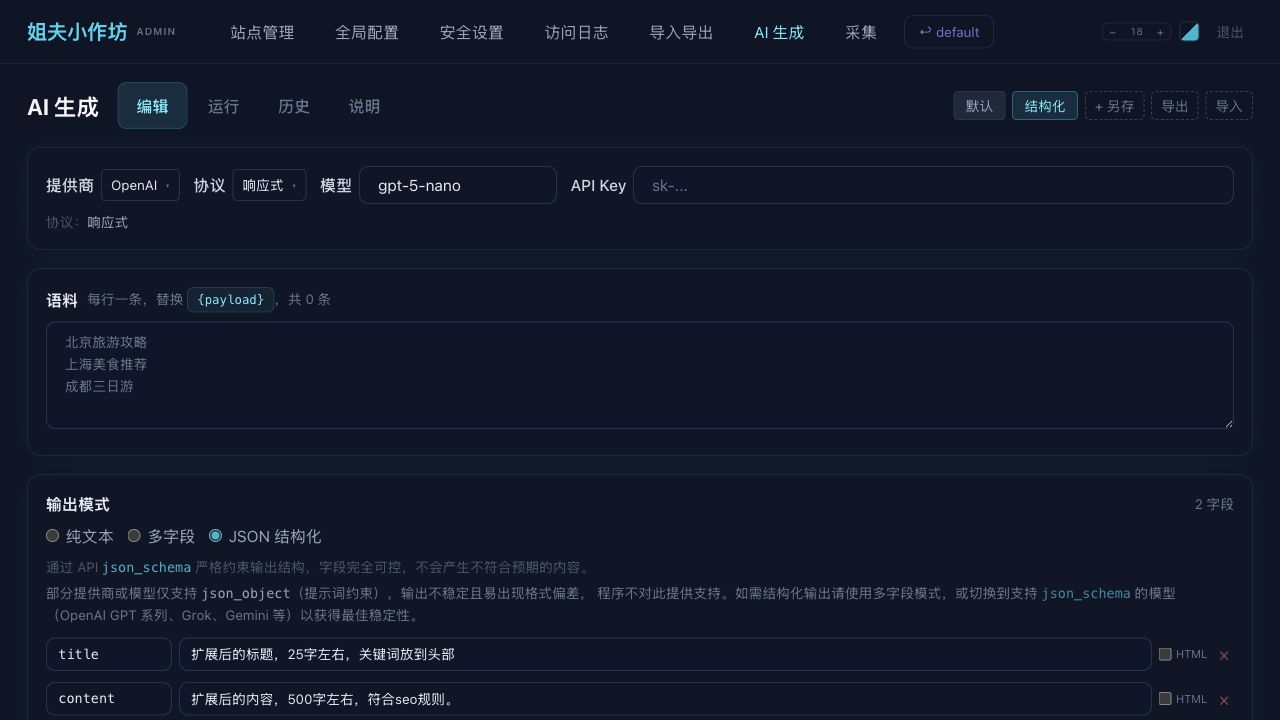
页面包含四个页签:
- 编辑:配置模型、语料、提示词、输出字段、保存位置、并发和重试。
- 运行:查看当前任务状态、日志和错误。
- 历史:查看历史任务,可继续或停止任务。
- 说明:查看接口协议和额外参数说明。
支持的提供商:
- OpenAI
- Grok
- Gemini
- DeepSeek
- 通义千问
- 火山引擎(豆包)
- 通用兼容接口
常用配置:
- 提供商:选择模型服务商。
- 协议:选择响应式或对话补全。
- 模型:填写模型名称。
- API Key:填写模型服务密钥。
- 语料:每行一条,作为
{payload}输入。 - 输出模式:纯文本、多字段、JSON 结构化。
- System Prompt:系统提示词。
- User Prompt:用户提示词。
- 保存到:选择站点、类型、分组、文件名规则。
- 并发:同时处理的数量。
- 重试:失败后的重试次数。
操作流程:
- 进入「AI 生成」。
- 选择或新建预设。
- 配置提供商、模型和 API Key。
- 输入语料。
- 设置输出字段和提示词。
- 选择保存站点、数据类型和分组。
- 点击「测试一条」验证输出。
- 确认无误后点击「开始生成」。
- 在「运行」页签查看进度。
- 任务完成后,到对应站点的 JSON 数据或文件数据中查看结果。
建议:
- 首次配置先用少量语料测试。
- 结构化内容优先使用 JSON 结构化或多字段模式。
- 并发数不宜过高,避免模型接口限速。
- API Key 属于敏感信息,不要截图外传。
10. 采集
「采集」用于从目标网站列表页提取链接,再进入内容页按正则提取字段,保存为站点数据。
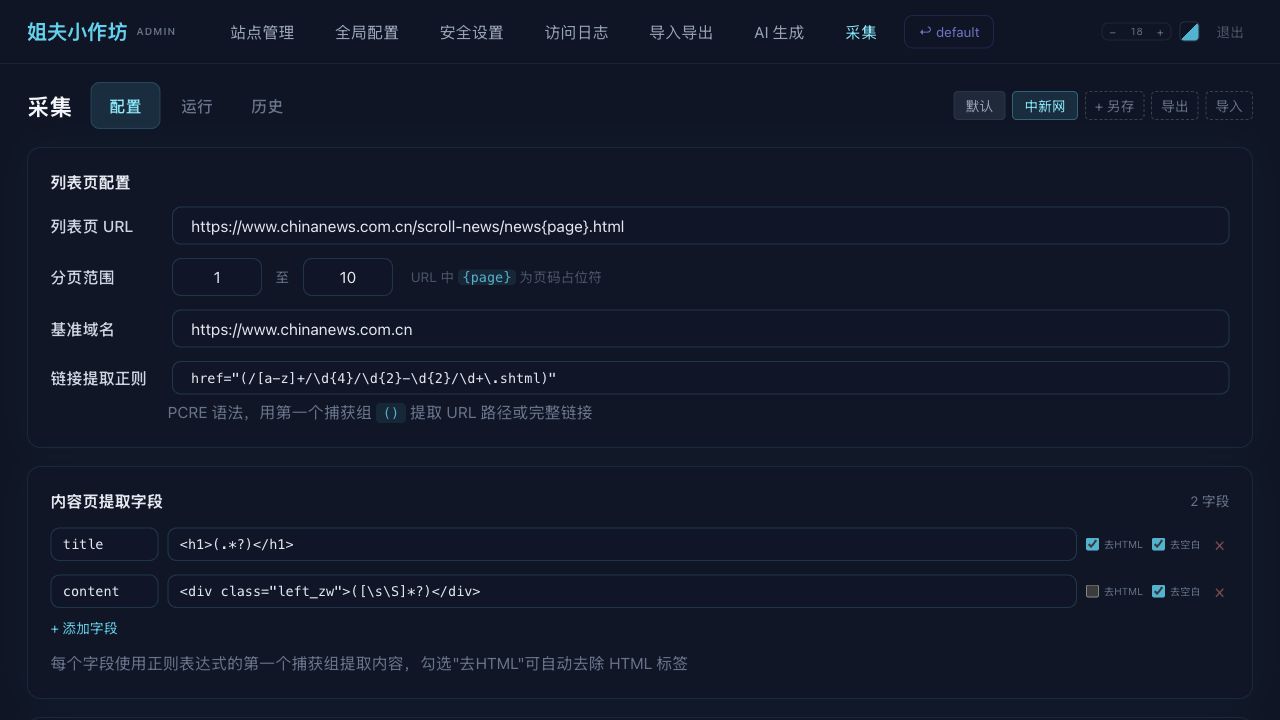
页面包含三个页签:
- 配置:设置列表页、分页、链接提取、内容字段、保存位置、高级参数。
- 运行:查看当前采集任务状态和日志。
- 历史:查看历史采集任务。
主要配置:
- 列表页 URL:支持
{page}作为分页占位符。 - 分页范围:设置起止页码。
- 基准域名:用于拼接相对路径。
- 链接提取正则:用第一个捕获组提取内容页地址。
- 内容页提取字段:每个字段使用一个正则,第一个捕获组为保存内容。
- 去 HTML:自动去除 HTML 标签。
- 去空白:清理多余空白。
- 保存站点:选择保存到哪个站点。
- 分组:保存到哪个数据分组。
- 文件名:可按序号、时间戳或字段生成。
- 高级设置:请求延迟、UA、编码、重试、并发等。
- 后处理:替换规则和拒绝规则。
- 定时采集:按间隔重复执行。
操作流程:
- 进入「采集」。
- 填写列表页 URL 和分页范围。
- 填写基准域名。
- 编写链接提取正则。
- 添加内容字段正则。
- 点击「测试抓取」验证链接和字段是否正确。
- 设置保存站点、分组、文件名规则。
- 点击「保存」保存配置。
- 点击「开始采集」提交任务。
- 在「运行」页签查看进度,完成后到对应数据分组查看结果。
建议:
- 正则先用测试抓取确认,再正式运行。
- 分页范围先小后大,避免一次采集过多。
- 采集公开可访问页面,遵守目标网站规则。
- 如果页面编码不是 UTF-8,应在高级设置中选择正确编码。
11. 模板标签
模板标签用于把文本数据、JSON 数据、文件数据、随机字符、时间、站点信息等内容插入模板,是模板制作中最重要的部分。
日常后台操作可继续阅读本文档。制作或调整模板时,可按需要查看核心模板标签手册和PHP 插件标签手册,里面提供完整语法、参数说明、示例和排查方法。
12. 常见业务流程
12.1 新建一个站点
- 进入「站点管理」。
- 点击「创建站点」。
- 填写站点 ID、备注、分类。
- 进入新站点详情。
- 在「模板管理」创建或上传模板。
- 在「站点配置」选择模板目录和站点类型。
- 在「域名绑定」绑定域名。
- 保存配置后访问域名测试。
12.2 批量生成内容
- 进入「AI 生成」。
- 配置模型、语料、提示词和输出字段。
- 保存到指定站点的 JSON 数据分组。
- 测试一条确认格式。
- 开始生成。
- 回到站点详情,检查 JSON 数据。
- 在模板中使用 JSON 标签调用内容。
12.3 批量采集内容
- 进入「采集」。
- 配置列表页和链接提取正则。
- 配置内容页字段正则。
- 测试抓取。
- 保存配置并开始采集。
- 回到站点详情,检查 JSON 或文件数据。
- 在模板中调用采集数据。
12.4 迁移或备份站点
- 进入「导入导出」。
- 选择要导出的站点。
- 勾选配置、数据、模板、访问控制页。
- 设置加密密码或留空。
- 点击「导出」保存
.jfpkg。 - 新环境中进入「导入」,上传
.jfpkg。 - 选择冲突处理方式并导入。
13. 常见问题
登录后看不到站点怎么办?
确认账号是否登录成功,刷新页面后重试。如果仍为空,请联系管理员检查站点目录和后台接口权限。
修改后台路径后打不开怎么办?
后台路径修改后必须使用新路径访问。例如从 /__jft3am_cp 改为 /admin_xxx 后,旧地址会失效。
为什么访客看不到真实内容?
检查「全局配置」或站点自定义访问控制。只有命中搜索引擎规则或使用预览密钥时,才会看到蜘蛛页面。
为什么日志没有数据?
检查「访问日志」是否开启。如果启用了「仅标记IP」,未标记 IP 的访问不会记录。
AI 生成失败怎么办?
检查 API Key、模型名称、接口地址、协议类型、余额和限速。先用「测试一条」确认配置正确。
采集不到内容怎么办?
优先检查链接提取正则和内容字段正则。正则必须使用第一个捕获组提取目标内容。
模板修改后前台没有变化怎么办?
可能启用了页面缓存。进入「全局配置」点击「清除缓存」,或在站点配置中关闭缓存后再测试。
14. 使用建议
- 生产环境请及时修改后台密码和后台路径。
- 大批量修改前先导出备份。
- 新模板、新正则、新 AI 提示词先在测试站点验证。
- API Key、后台地址、后台账号不要公开传播。
- 访问控制规则调整后,用预览密钥和真实访问分别测试。
- 定期检查访问日志,及时发现异常 IP、异常 UA 和域名访问问题。